
口播稿已经写好了、视频也录完了,缺的只是一份对得上时间的字幕。睿君字幕 TXT 转 SRT 工具把音视频和现成文案放在一起,自动生成带时间轴的 SRT:既可以只靠停顿把 TXT 逐句对上去,也可以用本机离线识别或豆包云识别产出时间轴,再用你的文案覆盖识别文本——文字是你写的原稿,时间是机器算的。
它解决的是哪一步:不是“把语音听成文字”,而是“已有文字,缺时间轴”,所以字幕内容和你的稿子完全一致。纯粹想从零听写成文字,请用睿君音视频字幕识别提取工具。
三种生成模式
| 模式 | 原理 | 适合 |
|---|---|---|
| 离线识别(默认) | 本机 faster-whisper 识别出时间轴,可直接用识别文本,也可勾选“用 TXT 覆盖离线识别文本”换成你的原稿 | 不联网、不上传音频,时间轴最贴合语音 |
| 按停顿匹配 TXT | 不做语音识别,用 VAD 找停顿切段,再把 TXT 按顺序对齐 | 速度最快,稿子和录音顺序一致时最省事 |
| 豆包云识别 | 填写 Access Token、APP ID,选择服务版本和资源 ID 走云端识别,同样可用 TXT 覆盖识别文本 | 本机性能有限,且已自备豆包语音账号 |
离线识别的三档模型怎么选
- Small(快速·草稿):压缩包约 426MB,速度最快,适合电脑配置一般、想先快速出一版字幕。
- Medium(推荐·均衡):压缩包约 1.3GB,速度和准确率均衡,第一次使用默认选它。
- Large-v3(最准·较慢):压缩包约 2.7GB,识别最准但速度最慢。选中后软件会自动勾选“过滤长静音”,避免无人声片段被凭空生成文字。
把模型文件夹(faster-whisper-small / faster-whisper-medium / faster-whisper-large-v3)放到软件同级目录后,“识别模型”下拉框会自动列出已放入的档位,可以只下一个,也可以都放。获取方式见下载包内说明。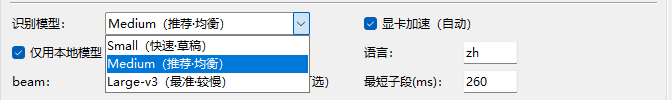
显卡加速(可选,仅 NVIDIA 显卡)
- “显卡加速(自动)”默认勾选:检测到 NVIDIA 显卡、且软件目录里有“显卡加速包”文件夹时自动用显卡识别,旁边显示“显卡加速已启用”。
- 用不了显卡时,状态会写明原因:“无N卡”“N卡驱动过旧”“N卡不可用”“缺加速包”“加速包异常”,需要处理的显示为橙色,并照常用 CPU 识别;具体处理办法见下方常见问题。
- 显卡加载模型或识别过程中出错(例如显存不足),会自动改用 CPU 重新识别当前文件,日志里写明原因,批量任务不会中断。
- 下载包内附 显卡检测工具:双击运行几秒出结论——能不能用显卡加速;用不了的话会直接指出是没有 N 卡、驱动太旧、驱动没装全、独显被禁用,还是缺加速包,并给出对应处理办法,可一键复制报告发给客服。只读取信息,不改动系统设置。
- 识别精度自动选择,不用手动设置;AMD、Intel 核显不需要下载加速包。
实测参考(GTX 1050Ti,识别 1 小时视频,已开过滤长静音,左为 CPU、右为显卡):Small 约 8 分钟→3 分钟,Medium 约 19 分钟→6 分钟,Large-v3 约 36 分钟→25 分钟。显卡越新提升越明显,有 N 卡时推荐“显卡加速 + Medium”。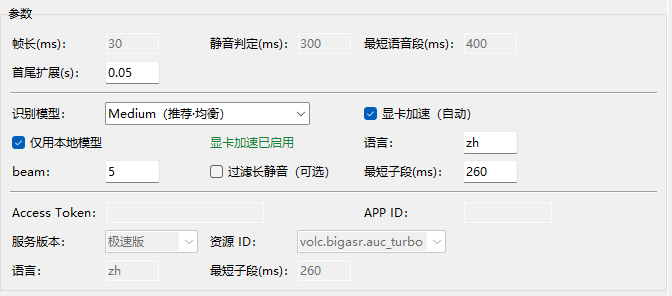
可调的切分参数
- 帧长、静音判定(默认 30ms / 300ms):决定多长的停顿算一句话结束。
- 最短语音段、最短子段(默认 400ms / 260ms):避免切出一闪而过的碎字幕。
- 首尾扩展(默认 0.05 秒):给每条字幕前后留一点余量,读起来不局促。
- 离线识别另可设置 beam、语言、仅用本地模型和过滤长静音。
为对齐准确度做的三件事
- 一段里分到多行文本时,会把该段再切成多条字幕,避免多句同时显示导致整条时间轴左移错位。
- VAD 不丢弃短语音段,短段优先与相邻段合并,结尾那一句不会被吞掉。
- 切分边界会在能量曲线里就近吸附到低谷(微停顿),比纯按比例切更贴合波形。
使用步骤
- 添加音频或视频文件(支持 MP3、WAV、M4A、AAC、FLAC、MP4、MKV、MOV、AVI 等 14 种格式),也可以添加整个文件夹。
- 需要用原稿时选择字幕 TXT:所有文件共用一个 TXT,或选“使用同名 TXT”批量处理。
- 选择生成模式;离线识别时选好识别模型,有 N 卡就保持“显卡加速(自动)”勾选。
- 按需要调整停顿和切分参数;输出目录默认是素材旁的“字幕输出_SRT”文件夹。
- 点击开始生成,可勾选“显示日志”查看处理过程,随时可以停止。
- 把 SRT 导入剪辑软件核对,个别位置手工微调。
购买前请注意
- 软件需要 FFmpeg 读取音视频:放在程序同级 ffmpeg 目录或加入系统 PATH,下载包内附环境包说明。
- 离线识别需要另外下载识别模型文件夹(Small 约 426MB、Medium 约 1.3GB、Large-v3 约 2.7GB,均为压缩包大小);显卡加速包约 527MB,仅 NVIDIA 显卡需要。
- 解压识别模型时请保持文件夹完整:Large-v3 必须包含 preprocessor_config.json(仅 340 字节),缺了会在识别时报特征维度不符的错误。
- 用 CPU 识别时需要足够的可用内存(含虚拟内存):Small 约 3GB、Medium 约 5GB、Large-v3 约 8GB,内存紧张的电脑建议用 Medium 或 Small。
- TXT 文案请保存为 UTF-8 编码(记事本“另存为”时编码选 UTF-8),否则可能读取失败。
- 显卡加速需要 NVIDIA 显卡,且显卡驱动支持 CUDA 12(约 528 版以上,可在命令提示符运行 nvidia-smi 查看右上角的 CUDA Version);用不了时会自动用 CPU,速度按 CPU 计算。
- 这是“有文案缺时间轴”的快速初稿工具,精度上限受停顿判断影响,正式发布前建议在剪辑软件里核对一遍。
不确定是否适合您的素材?建议先下载试用,用一段几分钟的音视频跑一遍,确认时间轴满意再下单。
软件界面与操作演示

常见问题
生成的字幕文字会不会有识别错字?
用“按停顿匹配 TXT”或勾选“用 TXT 覆盖识别文本”时不会,字幕内容就是你自己的稿子,机器只负责算时间。只有直接使用识别文本时才可能出现错字。
离线识别需要联网或上传音频吗?
不需要。离线模式在本机用 faster-whisper 处理,音频不出本机。改用豆包云识别时,音频才会送到云端。
三档识别模型选哪个?
大多数情况用 Medium。电脑配置一般、或想先快速出初稿用 Small;对准确率要求高、不赶时间用 Large-v3,并保持“过滤长静音”勾选。
没有 NVIDIA 显卡能用吗?
能。没有 N 卡或没放显卡加速包时,软件自动用 CPU 识别,功能完全一样,只是速度慢一些。AMD、Intel 核显不需要下载加速包。
显卡加速旁边显示“使用CPU”是什么原因?
看状态文字就知道原因:
① 无N卡:没有检测到 NVIDIA 显卡驱动,电脑没有 N 卡或没装显卡驱动;只有 AMD、Intel 显卡属于正常情况。
② N卡驱动过旧:驱动只支持 CUDA 12 以下(约 528 版以前)。到 NVIDIA 官网下载显卡最新驱动,安装后重启电脑即可;勾选“显示日志”可看到当前驱动支持的 CUDA 版本。
③ N卡不可用:驱动装了但找不到可用显卡,通常是独立显卡在设备管理器里被禁用或驱动损坏,重装官网驱动后重启。
④ 缺加速包:软件目录下没找到“显卡加速包”文件夹,检查位置和文件夹名。
⑤ 加速包异常:dll 文件不完整,重新下载加速包即可。
以上情况软件都会自动用 CPU 识别,不影响正常使用。
不想逐条对照的话,直接双击下载包内的显卡检测工具,它会把原因和处理办法直接写出来。
处理失败,提示“内存不足”怎么办?
表示电脑可用内存不够,模型没能加载。用 CPU 识别时 Large-v3 约需 8GB 可用内存(含虚拟内存),Medium 约 5GB、Small 约 3GB。
① 关闭浏览器、微信等占内存的程序后重试;
② 改用 Medium 或 Small 模型;
③ 把系统虚拟内存设为“自动管理所有驱动器的分页文件大小”,重启电脑后再试。
处理结束后软件会弹窗汇总失败原因,TXT 编码不对、找不到 FFmpeg 等常见问题也会给出对应办法。
识别时报错“Invalid input features shape … (1, 128, 3000) … (1, 80, 3000)”是什么意思?
这是 Large-v3 模型文件夹不完整,少了里面的 preprocessor_config.json(只有 340 字节,解压时容易漏掉)。Large-v3 用 128 维特征,缺这个文件会被按 80 维处理,一开始识别就报错;软件自动改用 CPU 重试后仍是同一个错,所以不是显卡的问题。把该文件补回模型文件夹即可,不必重新下载整个模型包。完整的 Large-v3 文件夹应有 5 个文件:config.json、model.bin、preprocessor_config.json、tokenizer.json、vocabulary.json;Small 与 Medium 本来就没有 preprocessor_config.json,属于正常。
字幕整体往前或往后偏了怎么办?
先确认 TXT 的句数和录音的实际停顿数是否对得上;再调整静音判定和最短语音段参数,让分段更贴近真实说话节奏,必要时把长句在 TXT 里拆行。
提示找不到 ffmpeg 怎么办?
把 ffmpeg 放在程序同级的 ffmpeg 目录下,或安装后加入系统 PATH。下载包内附有环境包说明。
使用过程中如需协助或有定制需求,请联系睿君科技。
